 Cloud y Business Apps
 Ciberseguridad
 Data & AI
 IoT y Conectividad
 Industria
 Salud
 Banca y Finanzas
 Sector Público
 Retail
 Turismo y Ocio
 Transporte y Logística
 Energía y Utilities
 Ciudades Inteligentes

Cien agentes de IA que valen por tres
Cada vez más soluciones combinan varios modelos de lenguaje y se quedan con la respuesta de la mayoría. Funciona peor de lo que parece si todos se equivocan en las mismas preguntas. Un artículo científico de Telefónica Tech y la Universidad de Valladolid explica por qué y cómo medirlo.
______
Si quieres formarte una opinión sobre un tema y preguntas a diez amigos, parece que tienes diez opiniones. Pero si los diez leen el mismo periódico, en realidad has preguntado a uno solo: te devolverán la misma versión, con los mismos aciertos y los mismos errores, y que estén de acuerdo no te dirá nada nuevo.
Esa situación es más habitual de lo que parece en IA generativa. Una práctica muy extendida consiste en no fiarse de un solo modelo: se pregunta a varios (o al mismo varias veces) y se da por buena la respuesta que más se repite. Si cinco agentes coinciden, parece razonable fiarse.
El problema es que muchos de esos modelos, por así decirlo, leen el mismo periódico. Cuando los errores de cada uno son independientes, se compensan entre sí. Cuando todos fallan a la vez, la mayoría no corrige el error: lo confirma.
La mayoría acierta cuando cada voto se equivoca a su manera, no cuando todos se equivocan igual.
La letra pequeña de la sabiduría de las masas
La justificación matemática de votar es el Teorema del Jurado de Condorcet, formulado en 1785. Dice, simplificando, que si cada votante acierta más de la mitad de las veces y vota de forma independiente, la mayoría acierta más que cualquiera de ellos, y su acierto se acerca al 100% a medida que se suman votantes.
La condición importante es la segunda: independencia. Y ahí está el problema. Dos copias del mismo modelo comparten los mismos datos de entrenamiento, el mismo ajuste y, a menudo, las mismas instrucciones (prompt). Incluso modelos de empresas distintas se han entrenado con buena parte del mismo internet. Estudios recientes que han comparado cientos de modelos confirman que tienden a fallar en las mismas preguntas.
Votar entre modelos solo aporta fiabilidad si sus errores son, al menos en parte, independientes.
Cuántos votos valen de verdad
En el artículo, publicado en la revista científica Discover Informatics, medimos esa dependencia con un número: la correlación entre los errores de los agentes. Vale 0 cuando que un agente de IA falle no dice nada sobre el otro, y 1 cuando siempre aciertan y fallan juntos.
A partir de ella se calcula algo muy útil para cualquier responsable de un proyecto de IA: el número efectivo de votantes, es decir, a cuántos agentes realmente independientes equivale el conjunto. El resultado es contundente: con una correlación de 0,3, cien agentes equivalen a unos tres independientes. Y por muchos más que se añadan, el conjunto nunca superará esa cifra.
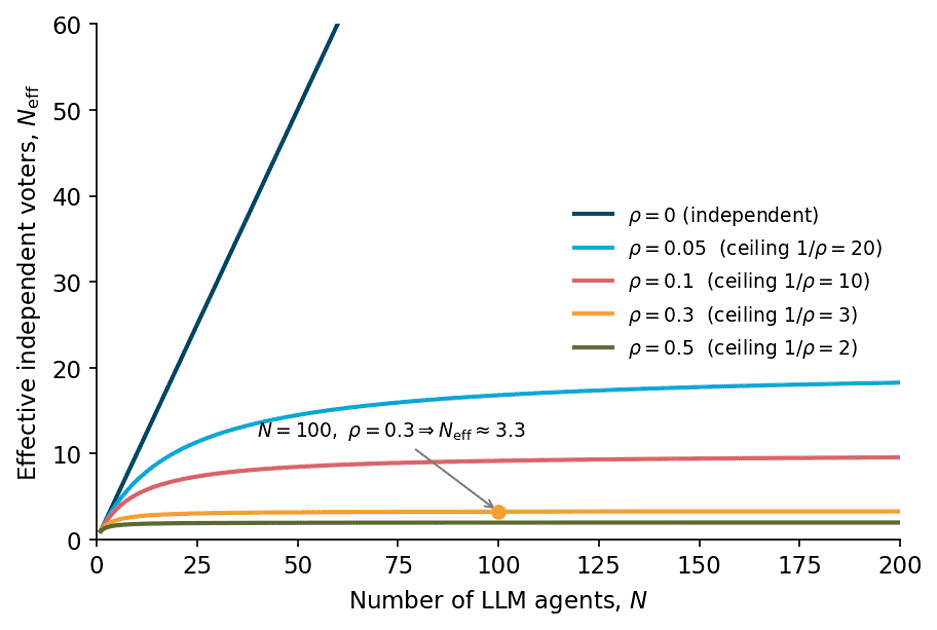 Cuántos votantes independientes «valen» en realidad N agentes (eje horizontal), según la correlación entre sus errores (ρ). Si son independientes (ρ = 0), cada agente suma; con ρ = 0,3, la curva se aplana en torno a tres por muchos agentes que se añadan. Fuente: Morante y Romero García-Rubio (2026), Discover Informatics, fig. 1 (CC BY 4.0).
Hay una consecuencia menos intuitiva. Con errores correlacionados, añadir agentes no lleva el acierto de la mayoría hacia el 100%, sino que lo estanca por debajo, y en algunos casos puede dejarlo por debajo del de un único modelo. Además, cuando la mayoría se equivoca, lo hace con más aplomo: el consenso refuerza el error en vez de corregirlo.
■ El número de agentes por sí solo dice muy poco de la fiabilidad de un sistema multiagente. Lo que importa es cuánto se parecen sus errores.
Cien agentes de IA que se equivocan juntos pueden valer lo mismo que tres que piensan por su cuenta.
Lo que vimos al medirlo con modelos reales
Para comprobar que esto se puede medir en la práctica, pusimos a prueba tres equipos de cinco agentes con 562 preguntas de MMLU, un examen de referencia con preguntas de 57 materias, desde derecho hasta química:
- Cinco muestras del mismo modelo, cambiando la aleatoriedad de la respuesta (la llamada temperatura).
- Cinco «personalidades» del mismo modelo, con instrucciones (prompt) que asignan un perfil distinto a cada una.
- Cinco modelos de cinco desarrolladores distintos (OpenAI, Mistral AI, DeepSeek, Moonshot AI y xAI).
Los dos primeros equipos, que a simple vista parecen diversos, resultaron casi idénticos: sus errores estaban correlacionados en un 0,85 y cada uno valía, en la práctica, poco más de un solo votante. Su voto por mayoría no mejoró al mejor de sus miembros. Las cinco muestras del mismo modelo fallaron a la vez en 71 preguntas, un 12,6% del total.
El equipo de modelos distintos se comportó de otra forma. Su correlación bajó a 0,38, equivalía a unos dos votantes independientes y su mayoría acertó el 92,3% de las preguntas, 8,4 puntos más que el modelo de partida. Los cinco fallaron a la vez en solo 14 preguntas (2,5%).
Aun así, hubo una sorpresa útil: el mejor modelo del grupo, por sí solo, acertó el 94%, más que la votación. Cuando los modelos tienen niveles muy distintos, contar todos los votos por igual penaliza al mejor.
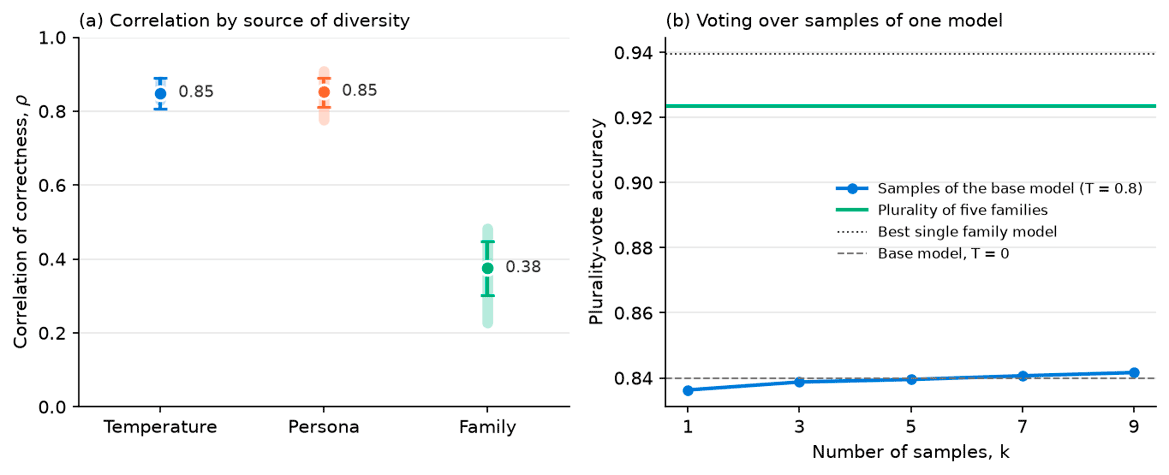 Izquierda: correlación entre los errores de cada equipo de cinco agentes (Temperature: muestras del mismo modelo; Persona: perfiles del mismo modelo; Family: modelos de cinco desarrolladores). Derecha: acierto del voto por mayoría al añadir muestras del mismo modelo (azul), frente al voto de los cinco modelos distintos (verde) y al mejor de ellos por separado (punteada). Fuente: Morante y Romero García-Rubio (2026), Discover Informatics, fig. 3 (CC BY 4.0).
■ Es una prueba de concepto acotada: un único examen y respuestas de una sola letra. Pero muestra que la medición es sencilla y barata con los conjuntos de evaluación que cualquier proyecto serio ya tiene.
Cambiar la temperatura o el «personaje» no diversifica: diversifican los modelos distintos.
Diversidad real frente a diversidad de maquillaje
De todo lo anterior se desprende la distinción que, a nuestro juicio, más utilidad tiene para quien diseña estos sistemas:
- Diversidad cosmética: más muestras del mismo modelo, otra temperatura, otro tono en las instrucciones (prompt). Hace que las respuestas parezcan distintas, pero no cambia dónde se equivoca el sistema.
- Diversidad estructural: modelos base distintos, entrenados con datos y objetivos diferentes. Es la que puede corregir errores, porque cada familia tiende a fallar en preguntas distintas.
■ Tampoco basta con sustituir el voto por un modelo que lea los argumentos de los demás y redacte una síntesis. Si los argumentos de partida comparten el mismo sesgo, la síntesis lo convertirá en un relato fluido y convincente, y será más difícil de auditar que un simple recuento.
La independencia entre agentes no se presupone: se diseña y se mide.
Qué preguntar antes de confiar en un sistema multiagente
El artículo propone una lista de comprobación de seis puntos para quien despliegue estos sistemas. Traducida a preguntas que cualquier empresa puede hacer a su proveedor (o a su propio equipo):
- ¿Cuánto se parecen los errores de los agentes? Debería haberse medido sobre un conjunto de preguntas con respuesta conocida.
- ¿A cuántos agentes independientes equivale el sistema? El dato relevante no es cuántos agentes hay, sino cuántos cuentan.
- ¿El conjunto mejora al mejor modelo por separado? Si no lo hace, el coste adicional no se justifica.
- ¿De dónde viene la diversidad? Modelos distintos o variaciones del mismo.
- ¿Cómo se combinan las respuestas y queda rastro? Sobre todo si un modelo resume a los demás.
- ¿Es aceptable el riesgo de un error compartido para el tipo de decisión que apoya el sistema?
■ Cuando el objetivo es detectar errores (revisión de contratos, análisis de riesgos, soporte a decisiones críticas), conviene pagar por la independencia. Cuando lo importante es una respuesta coherente, la correlación puede tolerarse, pero debe ser una decisión consciente.
Un consenso fácil entre modelos parecidos puede ser redundancia, no verdad.
Diez amigos que leen el mismo periódico no son diez fuentes, y cinco modelos que aprendieron de los mismos datos no son cinco votos. En un equipo de modelos de lenguaje, la variedad de puntos de vista no viene dada: hay que construirla y comprobar que existe. Añadir un modelo a la mesa no siempre añade un voto. A veces solo añade un eco.
 PARA SABER MÁS
Morante, S. y Romero García-Rubio, M. (2026). Correlation limits the reliability of ensemble decision making with large language models.
Discover Informatics, 1, 35.
Acceso abierto: https://doi.org/10.1007/s44564-026-00040-z
______
Imagen: Placidplace / Pixabay