 Cloud y Business Apps
 Ciberseguridad
 Data & AI
 IoT y Conectividad
 Industria
 Salud
 Banca y Finanzas
 Sector Público
 Retail
 Turismo y Ocio
 Transporte y Logística
 Energía y Utilities
 Ciudades Inteligentes

Arquitectura de datos: de lo accidental a lo diseñado
La arquitectura de datos que nadie diseñó
Toda empresa tiene una arquitectura de datos, aunque nadie la haya diseñado. Vive en las integraciones que cada proyecto creó con prisa, en las hojas de cálculo que sustituyen al informe que no cuadra y en las copias de clientes repartidas por varios sistemas. La pregunta es si esa arquitectura responde a una estrategia o al azar.
Durante años, esa arquitectura accidental fue un coste asumible. Hoy ya no lo es. La Inteligencia Artificial solo es tan fiable como los datos que la alimentan, y normas como el RGPD, el Reglamento de IA (AI Act) o el Reglamento de Datos (Data Act) refuerzan la necesidad de conocer el origen, el tratamiento y el uso de los datos.
El marco de referencia más extendido en gestión de datos, el DAMA-DMBOK, define la arquitectura de datos como el puente entre la estrategia de negocio y su ejecución tecnológica. Este artículo recorre los cinco pasos para construir ese puente: los principios, el mapa actual, la arquitectura objetivo, los flujos e integraciones y la hoja de ruta.
Toda empresa tiene una arquitectura de datos, aunque nadie la haya diseñado.
Principios de arquitectura de datos
Una arquitectura accidental es la suma de muchas decisiones razonables tomadas sin un criterio común. Los principios son ese criterio: unas pocas reglas, escritas en lenguaje de negocio, que ayudan a decidir cuando dos proyectos piden cosas distintas o cuando una solución rápida hipoteca el futuro. No dicen qué tecnología usar, sino qué debe asegurar cualquier tecnología que se elija. Los esenciales caben en tres compromisos.
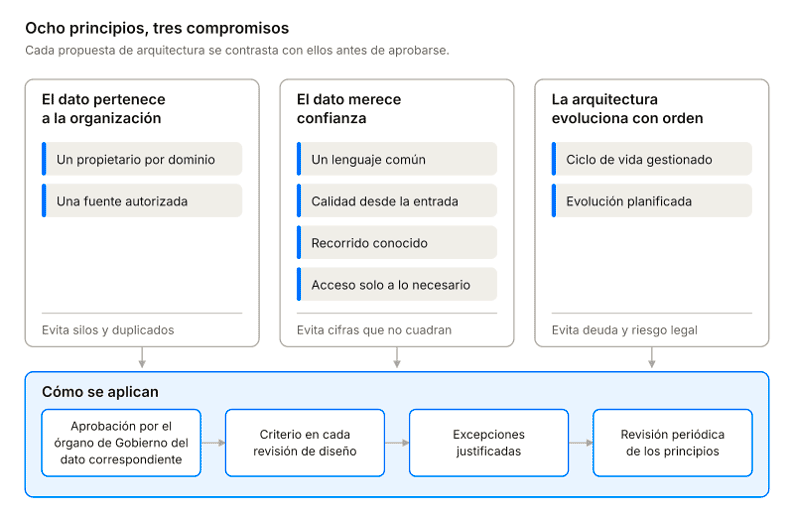 Figura 1. Principios de arquitectura agrupados en tres compromisos.
El dato pertenece a la empresa
No es del proyecto que lo crea ni del área que más lo utiliza. Cada dominio tiene un propietario que responde de su definición y de su calidad, y cada dato maestro tiene una única fuente autorizada desde la que se sincronizan las posibles copias. Esta es la respuesta directa a los silos y a las varias versiones de un mismo cliente.
El dato merece confianza
La confianza no se declara: se construye. Cada término significa lo mismo en toda la empresa gracias a un modelo de datos y un glosario comunes. La calidad se controla donde nace el dato, en lugar de corregirse aguas abajo. El recorrido de cada dato es conocido (linaje), de modo que cualquier cifra puede rastrearse hasta su origen. Y cada persona accede solo a lo que necesita, con el mínimo privilegio y conforme al RGPD.
La arquitectura evoluciona con orden
Todo dato tiene un ciclo de vida definido, desde que se captura hasta que se archiva o se elimina, con plazos de conservación claros que reducen el coste y el riesgo legal. Y la tecnología se elige por zona de datos y caso de uso, dentro de un plan, no por la novedad del momento.
■ Un principio solo es útil si cambia decisiones. Por eso, estos principios deberían ser aprobados por el órgano de Gobierno del dato correspondiente y servir de criterio en cada revisión de arquitectura: una propuesta que se aparte de alguno no queda descartada, pero debe justificar la excepción. Revisarlos de forma periódica evita que se queden en una declaración de intenciones.
Unos principios comunes evitan decisiones aisladas sobre los datos.
Mapa actual de la arquitectura de datos
El mapa actual responde a una pregunta sencilla: ¿qué datos tenemos hoy, dónde están, cómo se mueven y con qué calidad? Sin él, cualquier arquitectura objetivo es una suposición. Se construye reuniendo la documentación existente, validándola con los equipos que conocen y usan cada sistema, y completándola con la extracción automática de metadatos.
Conviene empezar por los datos críticos para el negocio y para el cumplimiento normativo. Como mínimo, debe recoger cinco elementos, que se resumen en la figura 2.
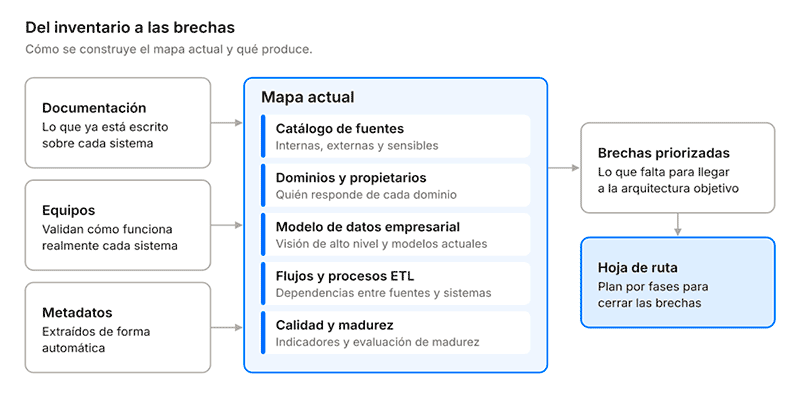 Figura 2. Cómo se construye el mapa actual y qué produce
Casi siempre aparecen los mismos síntomas:
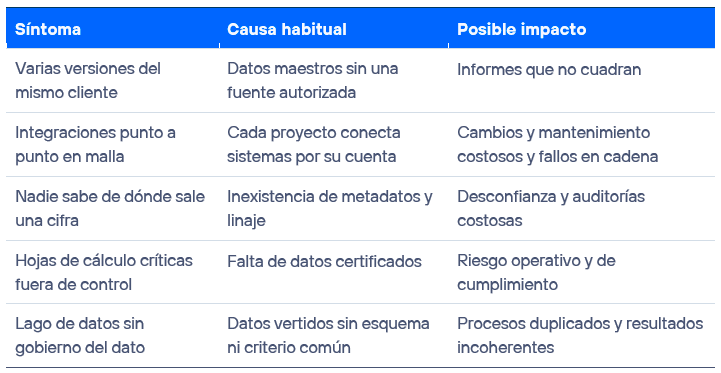
■ El resultado no es solo un inventario, sino una lista priorizada de brechas que alimenta la hoja de ruta.
Para diseñar el futuro, primero hay que conocer los datos actuales.
Arquitectura de datos objetivo
La arquitectura objetivo es una plataforma por capas con un gobierno del dato transversal, en la que cada dato tiene una fuente autorizada y cada consumidor accede a datos validados. Describe capacidades, no productos: la tecnología se elige después y debe poder cambiar sin rehacer el diseño.
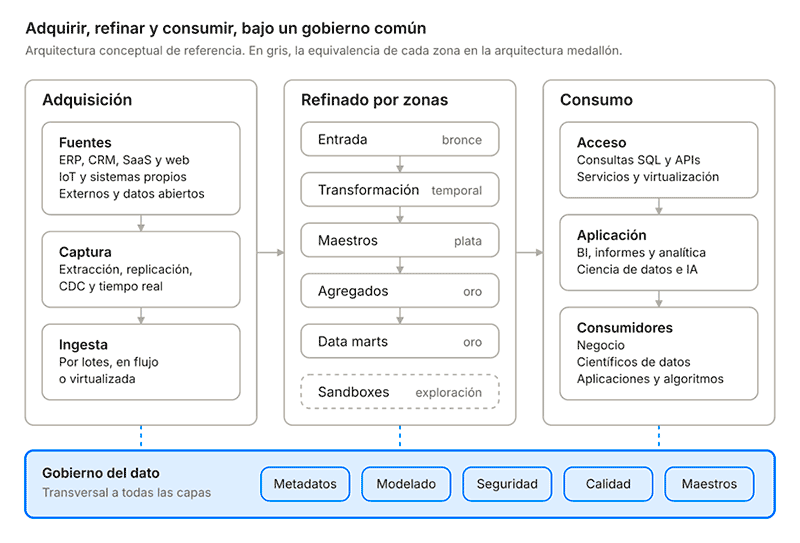 Figura 3. Arquitectura conceptual de referencia: adquisición, refinado, consumo y gobierno
El dato entra por una adquisición controlada, se refina zona a zona y se consume ya certificado. Las zonas son la pieza clave:
- Entrada (bronce/bronze): el dato tal como llega, con un esquema por sistema de origen.
- Transformación y maestros (plata/silver): datos depurados, integrados y unificados en un registro maestro (golden record), con un esquema por dominio.
- Agregados y data marts (oro/gold): modelos listos para consumir, con un esquema por caso de uso.
- Sandboxes: espacio libre para ciencia de datos, nunca accesible a las aplicaciones.
Es la estructura del lago de datos gobernado, o lakehouse, que une la flexibilidad del lago con el control del almacén de datos clásico. Sobre ella, cada empresa decide cuánto centralizar: una plataforma central encaja cuando hay pocos dominios, y un data mesh, en el que cada dominio publica sus datos como productos, encaja en organizaciones grandes y maduras. Muchas empiezan por lo primero y evolucionan hacia lo segundo.
■ El plano de todo ello es el modelo de datos empresarial: una visión conceptual de las entidades y reglas clave que se concreta en modelos lógicos y físicos, y en modelos dimensionales para la analítica. Todos viven en un repositorio versionado, que es la fuente de verdad de los cambios aprobados.
La arquitectura define las capacidades; la tecnología viene después.
Flujos e integraciones de datos
Los flujos definen cómo viaja cada dato desde donde nace hasta donde se usa, con qué latencia y con qué controles. La regla práctica es elegir la latencia que necesita el negocio, no la máxima que permite la tecnología.
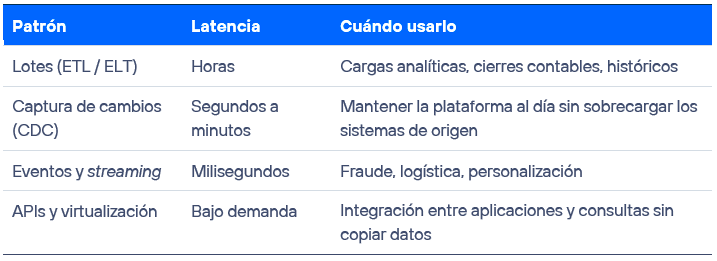
Pero la decisión más importante no es la tecnología, sino la topología. Cuando cada sistema se conecta con los demás, las interfaces crecen de forma cuadrática: con 10 sistemas pueden hacer falta 45 conexiones; con un concentrador, bastan 10.
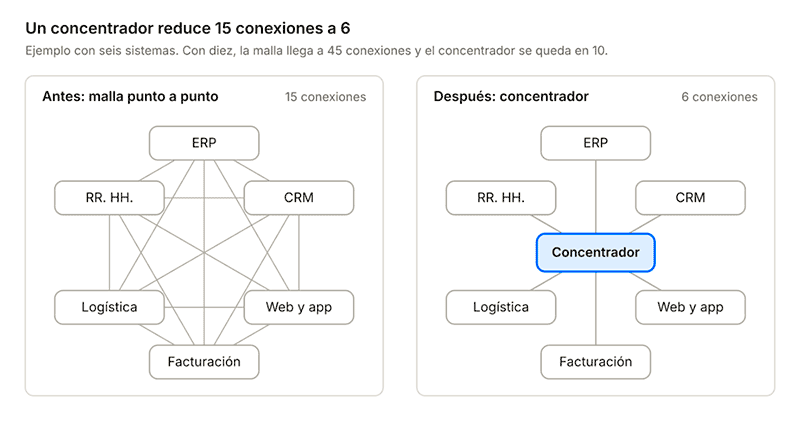 Figura 4. Integración punto a punto frente a concentrador, con seis sistemas
■ El concentrador funciona mejor con un modelo canónico, un formato común por entidad, y con contratos de datos: acuerdos versionados entre productor y consumidor sobre esquema, calidad y niveles de servicio. Para saber qué ocurre en cada momento, los flujos se documentan con una matriz CRUD, que indica qué proceso crea, lee, actualiza o borra cada entidad, y con un linaje capturado automáticamente que permite rastrear cualquier cifra hasta su origen.
La latencia debe responder a las necesidades del negocio.
Hoja de ruta para evolucionar la arquitectura de datos
La hoja de ruta convierte la distancia entre el mapa actual y la arquitectura objetivo en un plan por fases, con entregas de valor en cada una. Lo habitual es plantearla con un horizonte de tres a cinco años y empezar por los datos de los que dependen los demás, como los datos maestros.
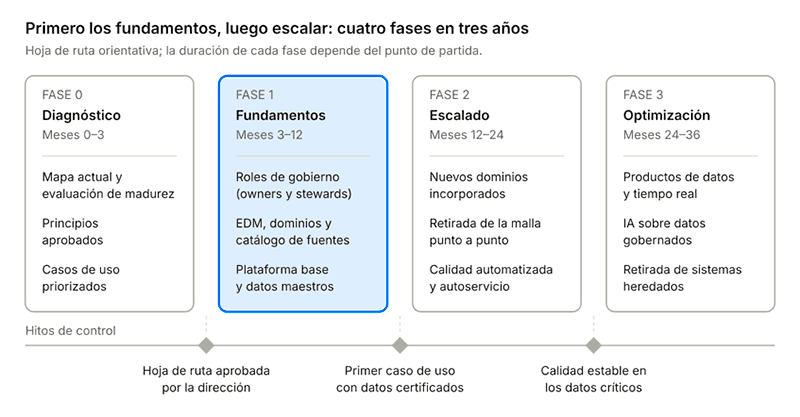 Figura 5. Hoja de ruta orientativa: cuatro fases y tres hitos de control
Para priorizar, cuatro criterios: las dependencias primero, el valor de negocio medible, el riesgo regulatorio y al menos una entrega visible por trimestre. La migración es incremental: lo nuevo convive con lo heredado hasta que puede sustituirlo.
Para medir el avance bastan unos pocos indicadores bien elegidos: el porcentaje de datos críticos con propietario, la cobertura del catálogo y del linaje, el índice de calidad de los datos críticos, las integraciones punto a punto retiradas y los días que se tarda en disponer de los datos de un nuevo caso de uso.
■ Nada de esto funciona sin patrocinio de la dirección, sin equipos mixtos de negocio y tecnología y sin un comité que revise el plan cada trimestre.
La arquitectura evoluciona por fases, con valor en cada una.
Conclusión
Una buena arquitectura de datos no se mide por la tecnología elegida, sino por la capacidad de la empresa para confiar en sus datos y cambiar sin tener que rehacerlos. Esa es la diferencia entre una arquitectura que frena y una que impulsa: en la primera, cada nuevo proyecto empieza buscando datos, conciliando cifras y negociando integraciones; en la segunda, empieza directamente por la pregunta de negocio. Y no se consigue de una vez: los cinco pasos de este artículo forman un ciclo, y cada revisión de la hoja de ruta empieza por actualizar el mapa actual y comprobar que los principios siguen vigentes.
Y el momento de empezar es ahora. La Inteligencia Artificial está multiplicando el valor de los datos bien gobernados y, a la vez, el coste de los que no lo están: un modelo alimentado con datos de origen incierto hereda todos sus defectos y los multiplica a escala.
Las empresas que hoy diseñan su arquitectura de datos construyen la base sobre la que competirán mañana. Al final, todo negocio tiene una arquitectura de datos. La única decisión real es si la deja en manos del azar o la diseña.
Una buena arquitectura convierte los datos en una base fiable para el negocio.
______
Referencia: DAMA-DMBOK: Data Management Body of Knowledge, 2.ª edición.
Technics Publications, 2017.