 Cloud y Business Apps
 Ciberseguridad
 Data & AI
 IoT y Conectividad
 Industria
 Salud
 Banca y Finanzas
 Sector Público
 Retail
 Turismo y Ocio
 Transporte y Logística
 Energía y Utilities
 Ciudades Inteligentes

Fuga de datos e IA: cómo reducir los riesgos en la empresa
La Inteligencia Artificial generativa ha entrado en las empresas mucho más rápido de lo que lo hicieron, en su momento, otras tecnologías corporativas. No ha necesitado grandes proyectos de implantación ni meses de integración. En muchos casos ha bastado con abrir un navegador.
Hoy es habitual utilizar IA para resumir un documento, revisar un contrato, analizar código, preparar una presentación o buscar información. El problema es que no siempre se hace con las herramientas que la empresa ha evaluado y autorizado. Y, en ocasiones, ni siquiera es evidente que se esté utilizando IA: puede estar integrada en una aplicación SaaS, en una extensión del navegador, en una herramienta de desarrollo o detrás de una API.
Ese conjunto de usos que escapan total o parcialmente al control de la empresa es lo que conocemos como shadow AI. Y plantea una cuestión especialmente relevante para los equipos de ciberseguridad: qué información estamos entregando a estos sistemas y qué ocurre con ella después.
La empresa necesita saber qué información comparte con la IA y qué ocurre con ella después.
Una fuga de información puede empezar con un prompt
No hace falta pensar en un ataque sofisticado. Una posible exposición de información puede empezar con algo tan cotidiano como copiar y pegar.
Un desarrollador introduce unas líneas de código en un asistente para localizar un error. Alguien de finanzas carga una hoja de cálculo para obtener un resumen. Un comercial pide a una IA que mejore una propuesta antes de enviársela al cliente.
Son acciones perfectamente comprensibles desde el punto de vista del usuario. El problema aparece cuando dentro de ese contenido viajan también credenciales, datos personales, información de clientes, código propietario o documentación interna.
Desde una perspectiva técnica, introducir información en un sistema de IA supone transferir datos para que sean procesados. Puede hacerse directamente mediante un prompt, adjuntando un fichero o dando acceso a un repositorio corporativo. Lo importante, desde el punto de vista de seguridad, es saber qué datos salen, hacia dónde, bajo qué condiciones y con qué garantías.
■ Además, el flujo de información no tiene una única dirección. Un asistente conectado a documentación interna también puede recuperar información a la que el usuario que realiza la consulta no debería tener acceso si los permisos del repositorio no se mantienen correctamente durante la consulta y la generación de la respuesta. Este escenario cobra especial importancia a medida que la IA se conecta con gestores documentales, repositorios de código, bases de conocimiento y otras aplicaciones empresariales.
La seguridad empieza por saber qué datos compartimos con la IA.
Shadow AI abarca más que un chatbot de IA
Uno de los errores habituales es reducir shadow AI al uso de chatbots públicos no autorizados. La realidad es bastante más amplia.
Puede existir una cuenta personal utilizada para una tarea profesional, pero también una función de IA incorporada a una aplicación que ya estaba aprobada por la empresa. Puede tratarse de una extensión capaz de leer el contenido de una página web o de un correo electrónico, una aplicación interna que consume un modelo mediante API o un agente con permisos para consultar información y ejecutar acciones sobre otros sistemas.
También pueden coexistir modelos públicos, servicios empresariales y modelos desplegados en infraestructura propia.
Esto hace que bloquear una lista de dominios tenga una eficacia limitada. Incluso una herramienta aprobada puede presentar perfiles de riesgo muy diferentes dependiendo de la cuenta utilizada, su configuración, los conectores habilitados, los datos que recibe o las condiciones que aplica el proveedor sobre conservación y utilización de esa información.
■ Por tanto, la cuestión no debería ser únicamente qué aplicaciones de IA están permitidas, también es preciso analizar para qué pueden utilizarse y con qué información.
Aprobar una herramienta no equivale a autorizar todos sus usos.
Antes de controlar, hay que conocer el uso real de la IA
Resulta difícil proteger aquello que no se ve. Una estrategia de seguridad para IA debería comenzar obteniendo una imagen suficientemente precisa de cómo se está utilizando dentro de la empresa.
No solo elaborar un inventario de aplicaciones. Interesa saber qué usuarios y áreas las utilizan, si acceden mediante cuentas personales o corporativas, si cargan archivos, qué volumen de información comparten y qué aplicaciones internas están accediendo a modelos mediante API.
Con la llegada de los agentes aparecen además nuevas preguntas. ¿a qué repositorios pueden acceder? ¿qué permisos tienen? ¿pueden únicamente consultar información o también modificarla? ¿pueden enviar un correo, crear un fichero o iniciar un proceso?
Para construir esta visión es posible combinar información procedente de la navegación, la red, los endpoints, las identidades y las aplicaciones cloud. El objetivo es entender el uso real antes de decidir dónde deben establecerse los controles.
■ Este análisis suele revelar además algo importante: determinadas herramientas de IA pueden haberse convertido ya en parte del proceso de trabajo de algunos equipos, aunque nunca hayan pasado por una evaluación formal.
No basta con saber qué herramientas de IA se usan: hay que conocer quién las utiliza y qué información comparte.
No todos los usos tienen el mismo riesgo
Traducir al inglés un texto publicado en una web corporativa no plantea el mismo escenario que cargar una base de clientes, analizar código propietario o resumir documentación confidencial.
Por eso, una política de IA útil necesita tener en cuenta tanto las características de la herramienta como el contexto en el que se utiliza.
Hay cuestiones técnicas que conviene revisar: dónde se procesa la información, cómo se cifra, durante cuánto tiempo se conserva, qué mecanismos de identidad y administración ofrece el servicio, si los datos pueden utilizarse para mejorar o entrenar modelos y qué capacidad tiene la empresa para desactivar determinadas funciones.
A partir de ahí, una herramienta puede estar autorizada para ciertos tipos de información, permitida únicamente mediante cuentas empresariales, limitada a determinados usuarios o directamente bloqueada cuando no ofrece las garantías necesarias.
■ Cuanto más sencilla sea esta política para el usuario, mejor. En el momento de copiar un documento en un asistente, nadie va a consultar un procedimiento de veinte páginas. Las reglas tienen que poder traducirse a decisiones concretas: qué herramienta puedo utilizar, con qué datos y para qué tarea.
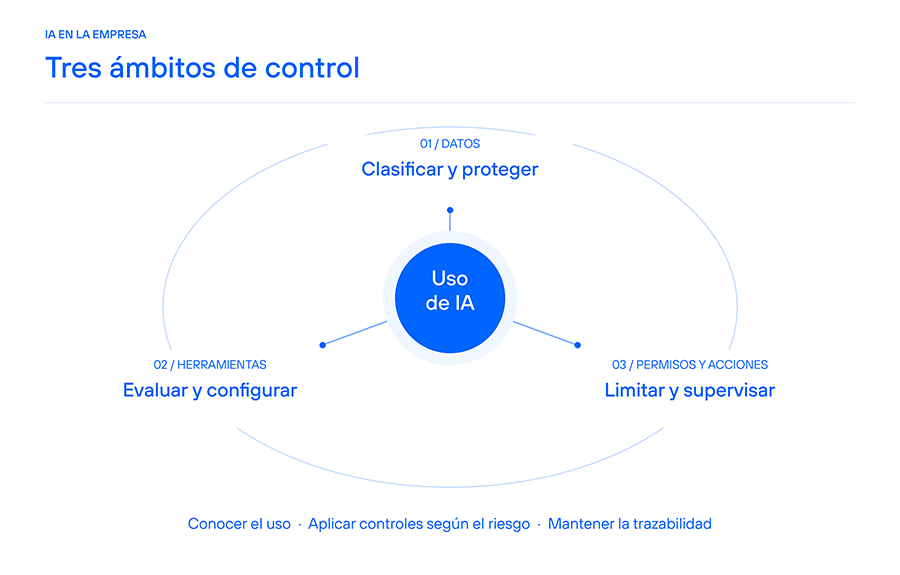
Los controles deben adaptarse a la herramienta de IA, los datos que recibe y la tarea que realiza.
El control de la IA tiene que acercarse al dato
Una vez conocido el uso, los controles pueden aplicarse en distintas capas.
Las soluciones de seguridad para navegación y aplicaciones cloud pueden ayudar a identificar servicios de IA y controlar cómo se accede a ellos. Dependiendo de la tecnología utilizada, es posible diferenciar entre cuentas corporativas y personales o actuar sobre operaciones concretas, como cargar un fichero o pegar información en una aplicación.
La protección del dato aporta otra capa. DSPM ayuda a descubrir dónde se encuentra la información sensible, clasificarla y conocer quién puede acceder a ella, mientras que DLP permite actuar cuando esa información se comparte con servicios de IA, desde una advertencia hasta el bloqueo.
■ En aplicaciones desarrolladas por la propia empresa aparece además otro punto de control: el AI Gateway. Centralizar a través de él el acceso a los modelos permite autenticar aplicaciones, controlar qué proveedores y modelos pueden utilizarse, gestionar cuotas y costes, registrar solicitudes y aplicar políticas sobre prompts y respuestas. También ayuda a evitar un problema bastante común en entornos que crecen rápidamente: acabar con claves de acceso distribuidas entre múltiples aplicaciones y equipos.
Proteger el dato requiere controlar también cómo llega a la IA.
Con los agentes, controlar el prompt no es suficiente
La evolución hacia sistemas agénticos cambia parte del problema de seguridad.
Un chatbot tradicional recibe información y devuelve una respuesta. Un agente puede ir bastante más lejos: consultar una base de datos, acceder a un repositorio, enviar un correo electrónico, modificar un registro o iniciar un proceso.
Aquí ya no se habla únicamente de proteger información, sino también de controlar acciones.
Los permisos mínimos, la separación de credenciales y la trazabilidad pasan a ser fundamentales. Un agente no debería disponer automáticamente de todos los privilegios del usuario o de la aplicación que lo ejecuta. Y consultar información debería ser una autorización distinta de actuar sobre ella.
En determinadas operaciones también será necesario mantener una aprobación humana antes de ejecutar la acción. No porque todas las decisiones de un agente sean necesariamente peligrosas, sino porque el impacto de un error cambia radicalmente cuando el sistema deja de generar texto y empieza a modificar sistemas reales.
■ Algo parecido ocurre con las arquitecturas RAG. Si un asistente consulta documentación corporativa, los permisos existentes en el repositorio original deberían mantenerse durante la recuperación y generación de la respuesta. De lo contrario, podemos construir un sistema técnicamente correcto que termine mostrando información válida a la persona equivocada.
Autorizar a un agente de IA a consultar información no implica autorizarlo a modificarla o enviarla.
Registrar lo necesario sin generar nuevos riesgos
La trazabilidad es necesaria para investigar incidentes y comprobar si las políticas funcionan, pero almacenar indiscriminadamente prompts y respuestas puede crear nuevas copias de información sensible.
Siempre que sea posible, conviene limitar el registro a metadatos (usuario, aplicación, modelo, fecha, tipo de información y acción aplicada) y proteger adecuadamente el contenido cuando sea imprescindible conservarlo. Estos eventos, integrados con las capacidades de monitorización y respuesta, también permiten detectar comportamientos anómalos o intentos recurrentes de eludir los controles.
Registrar todo lo que se envía a la IA y lo que responde puede crear copias innecesarias de información sensible.
De la visibilidad al control
El objetivo no es frenar la adopción de la IA, sino incorporarla al entorno empresarial sin perder el control sobre la información. Bloquear todas las herramientas de IA no elimina necesariamente el shadow AI: puede desplazar su uso hacia cuentas personales, dispositivos no gestionados o servicios menos visibles.
Un enfoque más práctico es comenzar identificando qué herramientas se utilizan y para qué, clasificarlas según el riesgo y ofrecer alternativas corporativas antes de aplicar controles progresivos. Las advertencias pueden ser suficientes en determinados casos, reservando el bloqueo para situaciones claras de riesgo, como el envío de credenciales, información regulada o documentación sensible a servicios no autorizados.
Con la llegada de los agentes, además, la cuestión no se centra solo en qué información puede conocer la IA, sino qué acciones le permitimos ejecutar.
■ Gestionar ese equilibrio será una parte cada vez más relevante de la estrategia de Ciberseguridad: facilitar que la empresa aproveche las capacidades de la IA, pero manteniendo la información, los permisos y las acciones dentro de unos límites conocidos y controlados. Más información →
Para aprovechar la IA sin perder el control de la información, hay que conocer cómo se utiliza y aplicar controles según el riesgo de cada uso.