 Cloud y Business Apps
 Ciberseguridad
 Data & AI
 IoT y Conectividad
 Industria
 Salud
 Banca y Finanzas
 Sector Público
 Retail
 Turismo y Ocio
 Transporte y Logística
 Energía y Utilities
 Ciudades Inteligentes

Edge Computing e IA distribuida: dónde ejecutar cada carga de trabajo
- Introducción
- Del Cloud centralizado a un continuo de computación
- Entrenamiento e inferencia: distintas fases, distintas necesidades
- ¿Cuándo tiene sentido llevar la IA al Edge?
- Latencia
- Volumen de datos y uso de la red
- Continuidad y resiliencia
- Localización y control del dato
- Movilidad
- De la visión artificial a los agentes de IA: aplicaciones de Edge AI
- Orquestar una IA distribuida
- Los retos de una IA distribuida
- Conclusión
Introducción
No todas las cargas de trabajo de IA necesitan la misma infraestructura. Entrenar un modelo de gran tamaño, analizar las imágenes de una cámara industrial o utilizar Inteligencia Artificial con información corporativa implican requisitos distintos de procesamiento, conectividad, latencia y gestión de datos.
La nube y los grandes centros de datos siguen siendo el entorno adecuado para muchas de estas cargas, especialmente cuando requieren gran capacidad de cómputo. Sin embargo, en sectores como la industria, el retail, la movilidad o la logística, buena parte de los datos procede de cámaras, sensores, máquinas o vehículos. Enviar continuamente esa información a una infraestructura centralizada puede alargar el recorrido de los datos por la red y retrasar respuestas que deben producirse cerca de la actividad. Algunas funciones también pueden ejecutarse directamente en un dispositivo local, siempre que disponga de capacidad suficiente.
En este escenario, Edge Computing ocupa el espacio intermedio. Acerca capacidad de procesamiento y almacenamiento al lugar donde se generan o utilizan los datos y permite ejecutar allí cargas que no conviene o no es necesario trasladar hasta el Cloud o un centro de datos centralizado y que, por capacidad u otros requisitos de la aplicación, tampoco interesa o es posible resolver por completo en el dispositivo local.
■ Cloud, Edge y dispositivos pueden formar así una arquitectura distribuida en la que cada parte de la aplicación se ejecuta donde mejor encajan sus requisitos. La decisión consiste en determinar qué ubicación resulta más adecuada para cada carga.
La decisión clave es ubicar cada carga de IA donde mejor encajen sus requisitos de cómputo, latencia, conectividad y tratamiento del dato.
Del Cloud centralizado a un continuo de computación
Cuando estos niveles trabajan de forma coordinada, la infraestructura funciona como un continuo de computación (Cloud Continuum). En un extremo se encuentran las regiones Cloud y los grandes centros de datos; en el otro, los dispositivos que generan o consumen información. Entre ambos, Edge incorpora capacidad de procesamiento y almacenamiento más cerca de usuarios, equipos y operaciones.
La ubicación depende de la aplicación. Una carga que priorice capacidad de cómputo y escalabilidad puede ejecutarse de forma centralizada. Una carga sensible a la latencia, que genere grandes volúmenes de información de manera continua o necesite procesar cerca de donde se generan los datos, puede beneficiarse de Edge. Y algunas funciones pueden ejecutarse directamente en el dispositivo local.
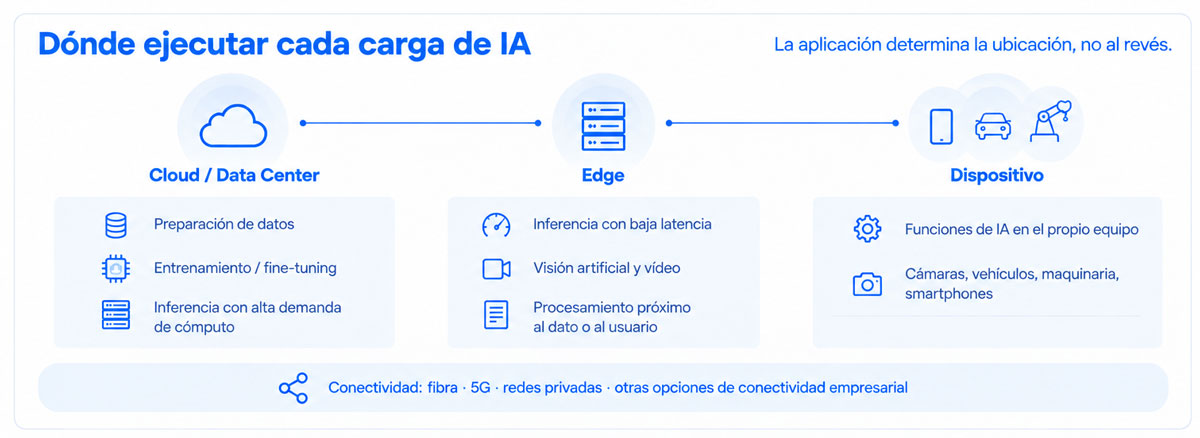
Para que estos niveles funcionen como una arquitectura distribuida, la conectividad es esencial. Fibra, 5G, redes privadas y otras opciones de conectividad empresarial enlazan dispositivos Edge y Cloud y permiten combinar recursos situados en distintos puntos. Pero conectarlos no basta: también hay que gestionar y coordinar dónde se ejecutan las aplicaciones, en lugar de tratar cada nodo como una infraestructura aislada.
■ En España, Telefónica ha reforzado esta capa con el despliegue de 17 nodos Edge y servicios B2B asociados a diferentes zonas productivas. Su integración con las redes fija y móvil permite ejecutar determinadas cargas más cerca de las operaciones de las empresas cuando el caso de uso lo requiere.
Entrenamiento e inferencia: distintas fases, distintas necesidades
El ciclo de vida de un modelo ayuda a concretar este reparto. La preparación de grandes conjuntos de datos, el entrenamiento y determinados procesos de fine-tuning requieren una elevada capacidad de cómputo, por lo que suelen ejecutarse en infraestructuras centralizadas y especializadas.
Con la inferencia, en cambio, el reparto puede ser más flexible. Una vez entrenado, el modelo utiliza nuevos datos para generar una predicción, una clasificación, una respuesta o una decisión. Algunas inferencias siguen necesitando grandes recursos y se ejecutan de forma centralizada; otras pueden ejecutarse en Edge cuando la proximidad aporta una ventaja concreta.
De forma simplificada:
- Cloud y grandes centros de datos: preparación de datos, entrenamiento y fine-tuning, además de inferencias que demandan mucha capacidad de cómputo o no tienen requisitos estrictos de proximidad.
- Edge: determinadas cargas de inferencia, visión artificial, procesamiento de vídeo, RAG y otras aplicaciones que se benefician de ejecutarse cerca de los datos o de los usuarios.
- Dispositivo: aplicaciones de IA capaces de ejecutar determinadas funciones directamente en smartphones, cámaras, vehículos, maquinaria u otros equipos.
■ Estas categorías no establecen fronteras rígidas. Una misma aplicación puede utilizar varios niveles: entrenar o actualizar un modelo en una infraestructura centralizada, ejecutar la inferencia cerca de la operación y reservar al dispositivo las funciones que puede resolver localmente.
¿Cuándo tiene sentido llevar la IA al Edge?
Edge Computing aporta valor cuando la proximidad resuelve una necesidad concreta de la aplicación. No hay un único criterio; normalmente intervienen varios.
Latencia
Reducir el recorrido de red entre el punto donde se genera un dato y aquel donde se procesa puede acortar el tiempo de respuesta. Esto resulta especialmente relevante cuando una aplicación debe reaccionar en tiempos muy ajustados, como sucede en determinados procesos industriales, de visión artificial o movilidad.
Volumen de datos y uso de la red
Cámaras, sensores industriales y otros dispositivos pueden producir grandes cantidades de información de forma continua. Si una decisión puede tomarse a partir de una alerta, una clasificación o un resultado ya procesado, no siempre es necesario trasladar todos los datos hasta una infraestructura más alejada.
Continuidad y resiliencia
Mantener determinadas funciones cerca de la operación puede reducir la dependencia de recursos remotos. Edge, sin embargo, no garantiza por sí solo la continuidad: el resultado depende del diseño de la aplicación, la infraestructura y la conectividad.
Localización y control del dato
Algunos casos necesitan controlar dónde se procesa o almacena determinada información. Edge permite incorporar esa ubicación al diseño de la arquitectura. La proximidad, sin embargo, no equivale automáticamente a privacidad, soberanía o cumplimiento normativo; estos requisitos exigen medidas adicionales.
Movilidad
Cuando usuarios, vehículos o dispositivos cambian de ubicación, también puede cambiar el nodo más adecuado para ejecutar o servir la aplicación. Latencia, localización, conectividad, recursos disponibles, capacidad de red o requisitos sobre los datos pueden influir en esa selección.
■ Estos factores suelen combinarse. El diseño debe identificar qué partes de la aplicación encajan mejor en Cloud, cuáles se benefician de Edge y cuáles pueden ejecutarse en el dispositivo.
Edge aporta valor cuando la proximidad cambia el comportamiento de la aplicación: reduce la latencia, evita movimientos innecesarios de datos o permite mantener determinadas funciones cerca de la operación.
De la visión artificial a los agentes de IA: aplicaciones de Edge AI
Los casos de uso ayudan a entender este reparto. La visión artificial es uno de los ejemplos más claros. En una fábrica puede utilizarse para detectar defectos o analizar procesos de producción; en retail, para reconocimiento de imágenes, prevención de pérdidas u otras aplicaciones basadas en vídeo. En industria y logística aparecen además escenarios como el mantenimiento predictivo, la robótica, la optimización de flotas o el seguimiento de activos.
Procesar las imágenes cerca del lugar donde se capturan evita trasladar necesariamente todo el flujo de vídeo a una infraestructura remota. La aplicación puede realizar allí la inferencia y enviar después una alerta, una clasificación o únicamente la información que necesita el resto del sistema.
El transporte ferroviario ofrece un ejemplo de esta arquitectura. Telefónica y CAF han desarrollado un piloto que combina 5G SA, Network Slicing, Edge Computing e IA. La solución analiza mediante visión artificial imágenes captadas en el interior de los trenes y procesa la información en el nodo Edge más próximo, sin necesidad de instalar un nodo de procesamiento en cada vagón.
También la IA generativa amplía estos escenarios. En aplicaciones basadas en Retrieval-Augmented Generation (RAG), la inferencia y la recuperación de información pueden situarse cerca de los datos corporativos con los que trabaja la aplicación. El mismo planteamiento puede aplicarse a determinados agentes conversacionales y otras soluciones que combinan modelos de IA con información empresarial.
■ Estas capacidades ya forman parte también de la propuesta Edge para empresas. El portfolio de Telefónica se apoya en Telefónica Tech Cloud Platform e incorpora capacidad de cómputo con GPU y servicios de IA mediante agentes y RAG. Esto amplía las opciones para situar determinadas cargas de IA más cerca del dato o del usuario cuando el caso de uso lo requiere.
Orquestar una IA distribuida
Conforme aumentan las posibles ubicaciones de ejecución surge otro reto: disponer de recursos distribuidos no basta, lo que requiere decidir cuáles utilizar y gestionarlos como parte de una misma arquitectura.
La orquestación permite incorporar a esa decisión factores como la latencia, la localización, la conectividad, los recursos disponibles, la capacidad de red o los requisitos relacionados con los datos.
En este punto Smart Edge facilita la selección del nodo adecuado y la instanciación de aplicaciones sobre una infraestructura distribuida. Así, una aplicación no tiene que quedar vinculada de forma permanente a una única ubicación.
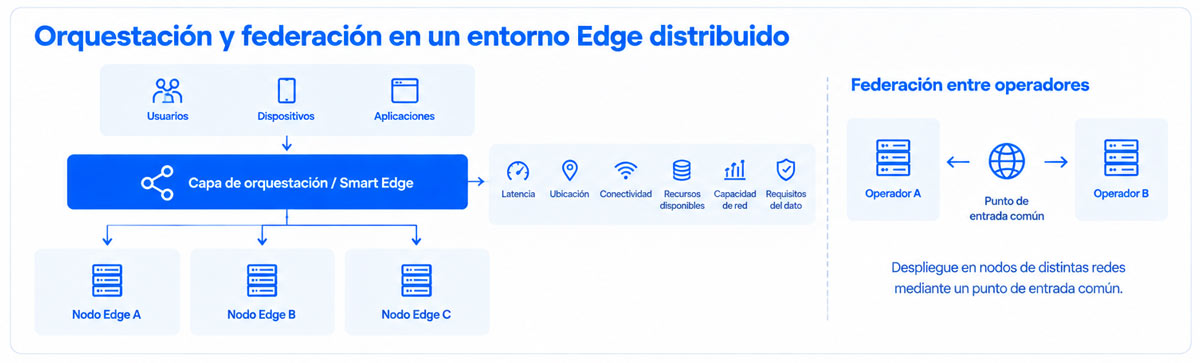
Esta capacidad resulta especialmente relevante en escenarios de movilidad. Si un usuario, vehículo o dispositivo cambia de posición, también puede cambiar el nodo que ofrece las condiciones adecuadas para prestarle el servicio. La gestión deja de centrarse en nodos aislados y pasa a coordinar el conjunto.
■ La federación entre entornos Edge de distintos operadores puede extender este modelo, permitiendo desplegar aplicaciones sobre nodos de diferentes redes mediante un punto de entrada común. Es, por tanto, una de las piezas de un Cloud-Edge Continuum en el que aplicaciones y recursos pueden distribuirse entre diferentes niveles e infraestructuras.
Los retos de una IA distribuida
Esta flexibilidad tiene contrapartidas. Acercar el procesamiento a usuarios, dispositivos y operaciones implica trabajar con infraestructuras que no siempre ofrecen la misma capacidad que un gran centro de datos.
Los recursos de un nodo Edge pueden ser más limitados, por lo que modelos y aplicaciones deben ajustarse a la capacidad disponible. Cuando sea necesario, técnicas como la cuantización, la poda o la destilación del conocimiento pueden reducir los requisitos de determinados modelos y facilitar su ejecución en estos entornos.
La distribución también aumenta la complejidad operativa. Si una aplicación funciona en distintas ubicaciones, los equipos deben coordinar versiones, actualizaciones, despliegues, observabilidad y monitorización entre varios entornos para mantener una gestión coherente de los modelos a lo largo del ciclo de vida de la IA.
La seguridad forma parte del mismo reto. Procesar determinados datos más cerca de su origen puede reducir algunos movimientos de información, pero una arquitectura distribuida incorpora más nodos, interfaces y componentes que gestionar y proteger. Los equipos deben integrar la seguridad en las aplicaciones de IA desde el diseño y mantener políticas coherentes en toda la infraestructura.
■ Por eso, llevar una carga de IA al Edge debe responder a una necesidad concreta. La proximidad aporta valor cuando mejora una variable relevante para la aplicación; añadir otra capa de infraestructura sin esa justificación aumenta la complejidad sin aportar necesariamente una ventaja.
Conclusión
La decisión de dónde procesar pasa a formar parte del propio diseño de las aplicaciones de IA, que cada vez se integran en más procesos,
Los grandes centros de datos mantienen un papel central en el entrenamiento y las cargas intensivas en procesamiento. Los dispositivos pueden asumir determinadas funciones cuando cuentan con capacidad suficiente. Entre ambos, Edge acerca el procesamiento cuando la latencia, el volumen de datos, la movilidad, la continuidad o la localización de la información lo aconsejan.
El despliegue de infraestructuras Edge, su integración con las redes de comunicaciones y la incorporación de capacidades de IA amplían las opciones disponibles. Cloud, Edge y dispositivo local no tienen por qué plantearse como alternativas excluyentes: pueden formar parte de un mismo continuo de computación.
El diseño debe partir de la aplicación. Sus requisitos determinan dónde conviene procesar, qué conectividad necesita, cómo coordinar los diferentes recursos y cómo operar y proteger la solución durante todo su ciclo de vida.
Cloud, Edge, conectividad y dispositivos forman una misma arquitectura distribuida; el valor está en coordinar dónde debe ejecutarse cada parte de la aplicación.
Actualizado: 09.2026